Hỏi cho khéo, nhồi cho đầy… nhưng vẫn chưa thành hệ thống
Trong phần này · 6 mục
- I. In-context learning không làm trọng số thay đổi
- II. Một cỗ máy hoàn thành chuỗi, không phải kho sự thật
- III. InstructGPT: khi sự hài lòng của con người trở thành tín hiệu huấn luyện
- IV. RAG: từ một kiến trúc học được đến một pipeline thường bị đóng băng
- V. Tài liệu đúng vẫn có thể bị bỏ quên giữa ngữ cảnh
- VI. Giới hạn của một kiến trúc chỉ xoay quanh ngôn ngữ
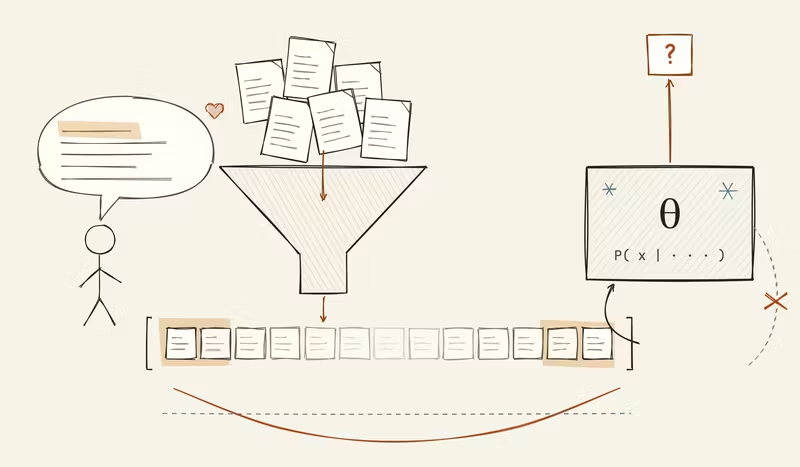
Ở tầng vận hành cơ bản, mô hình ngôn ngữ không kiểm tra sự thật, tự xác lập mục đích hay thực thi hành động. Nó nhận một chuỗi token và dự đoán token nào nên xuất hiện tiếp theo. Cơ chế ấy có thể tạo ra những năng lực đáng kinh ngạc. Vấn đề bắt đầu khi chúng ta đánh đồng một câu trả lời thuyết phục với một câu trả lời có căn cứ; đánh đồng khả năng mô tả hành động với khả năng thực sự hoàn thành hành động.
Sự nhầm lẫn này đã nuôi dưỡng vô số bản demo ấn tượng. Nhưng demo chỉ cho thấy mô hình có thể nói gì trong một tình huống được dàn dựng tốt. Một hệ thống thực thụ phải trả lời những câu hỏi khó hơn: nó biết điều gì, căn cứ vào đâu, được phép làm gì, đã thực sự làm gì và làm sao chứng minh được kết quả.
Bài viết này mổ xẻ khoảng cách ấy qua hai kỹ thuật đã định hình làn sóng AI hiện tại: prompt engineering và context engineering. Đáng chú ý nhất là phiên bản sơ khai của context engineering, thường được gọi nôm na là "nhồi ngữ cảnh": đưa thêm chỉ dẫn, ví dụ và tài liệu vào đầu vào với hy vọng mô hình sẽ trở nên đáng tin cậy hơn. Cả hai kỹ thuật đều có giá trị, nhưng chúng chủ yếu thay đổi thứ mô hình nhìn thấy trước khi trả lời. Còn mô hình được phép làm gì, dựa vào nguồn nào và kết quả được xác minh ra sao lại là bài toán của kiến trúc hệ thống.
I. In-context learning không làm trọng số thay đổi
Tháng 5 năm 2020, Brown và cộng sự công bố GPT-3:1 mô hình 175 tỷ tham số, được tiền huấn luyện trên khoảng 300 tỷ token và có cửa sổ ngữ cảnh 2.048 token. Bài báo không giới thiệu một chatbot hoàn chỉnh. Điều đáng chú ý hơn là một quan sát: khi mô hình đủ lớn, chỉ cần đưa chỉ dẫn hoặc vài ví dụ vào đầu vào, nó đã có thể thực hiện một nhiệm vụ mới mà không cần fine-tuning thêm.
Ta đặt một số ví dụ trước câu hỏi; mô hình nhận ra khuôn mẫu rồi tiếp tục theo khuôn mẫu ấy. Trên LAMBADA, GPT-3 đạt độ chính xác 76,2% ở chế độ zero-shot, giảm còn 72,5% ở one-shot và tăng lên 86,4% ở few-shot. Toàn bộ sự thay đổi diễn ra trong lúc suy luận, không có bước tính gradient và không có trọng số nào được cập nhật.
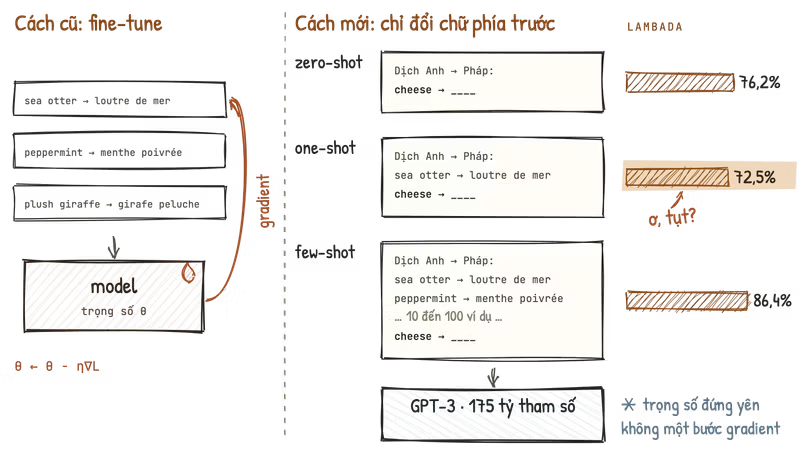
Hình trên đọc từ trái sang phải. Bên trái là cách cũ: mỗi cặp ví dụ đi qua mô hình, sinh ra một gradient, và trọng số bị sửa đi một chút, lặp lại hàng nghìn lần. Bên phải là cách GPT-3 làm: vẫn mô hình 175 tỷ tham số ấy, không bị sửa gì cả. Giữa ba dòng zero-shot, one-shot và few-shot, thứ duy nhất khác nhau là số ví dụ nằm trước câu hỏi.
Đó là in-context learning, tức khả năng thích ứng theo ngữ cảnh ngay trong lúc suy luận.
Điểm dễ gây nhầm lẫn nằm ngay trong chữ "học". Mô hình có thể biểu hiện như thể vừa học được một quy tắc, nhưng cái thay đổi chỉ là trạng thái tính toán tạm thời do ngữ cảnh hiện tại tạo ra. Trọng số vẫn giữ nguyên. Khi ngữ cảnh biến mất, hiệu ứng ấy cũng biến mất, trừ khi ứng dụng chủ động lưu lại rồi đưa thông tin vào lần gọi tiếp theo.
Kết quả LAMBADA còn cho thấy một điều khác: không phải cứ thêm ví dụ là tốt hơn. Chế độ one-shot kém hơn zero-shot, một phần vì cách định dạng đầu vào khác nhau và vì một ví dụ đơn lẻ có thể dẫn mô hình theo khuôn mẫu không phù hợp. Nội dung quan trọng, nhưng cách trình bày, thứ tự và định dạng cũng có thể làm kết quả đổi khác đáng kể.
Từ đây, prompt engineering dần trở thành một chuyên môn: thay đổi thứ mô hình nhìn thấy để điều hướng thứ nó tạo ra. Đây là kỹ thuật hữu dụng, nhưng có giới hạn rõ ràng. Prompt có thể định hướng hành vi trong một lượt suy luận; tự nó không tạo ra trí nhớ dài hạn, không cập nhật trọng số và không cấp thêm quyền hành động cho hệ thống.
II. Một cỗ máy hoàn thành chuỗi, không phải kho sự thật
Với mô hình tự hồi quy, bài toán cốt lõi có thể viết gọn như sau:
Từ chuỗi token , mô hình ước lượng token có khả năng xuất hiện tiếp theo.
Trong phép tính ấy không mặc nhiên có một ô dành cho "doanh thu kho tháng trước". Nếu dữ liệu nội bộ không nằm trong trọng số, không được đưa vào ngữ cảnh và cũng không thể được lấy từ một công cụ bên ngoài, mô hình không có nguồn đáng tin cậy để biết con số đó.
Tuy vậy, nó vẫn có thể tạo ra một câu trả lời nghe rất hợp lý. Trong dữ liệu ngôn ngữ, cụm "doanh thu tháng trước là…" thường được nối tiếp bằng một con số. Mô hình có thể hoàn thành khuôn câu mà không hề tra sổ cái. Đây là khác biệt căn bản giữa tạo ra một chuỗi có vẻ đúng và truy xuất một sự kiện đã được kiểm chứng.
Gọi mọi trường hợp như vậy là "ảo giác" không sai, nhưng cái tên dễ khiến ta tưởng mô hình vừa phản bội một cam kết về sự thật. Trên thực tế, tiền huấn luyện chủ yếu dạy mô hình dự đoán ngôn ngữ, chứ không tự động cung cấp cho nó cơ chế kiểm toán, nguồn dữ liệu hiện hành hay nghĩa vụ phải để trống khi thiếu bằng chứng.
Kalai và cộng sự (2025) phân tích vấn đề này từ góc nhìn thống kê và cơ chế đánh giá.2 Khi các phát biểu đúng và sai khó phân biệt trong dữ liệu, lỗi vẫn nảy sinh dưới áp lực tiền huấn luyện thông thường. Sau đó, nhiều bảng đánh giá lại tiếp tục khuyến khích phỏng đoán: trả lời "không biết" chắc chắn không được điểm, còn đoán thì vẫn có xác suất đúng. Nếu chỉ thưởng cho độ chính xác mà không phạt đủ nặng câu trả lời sai nhưng tự tin, hệ thống sẽ học cách làm một thí sinh thích đoán hơn là một người giữ sổ sách thận trọng.
Đó không phải là một khiếm khuyết đạo đức nằm đâu đó trong mạng nơ-ron. Đó là hệ quả của dữ liệu, mục tiêu huấn luyện và cách chúng ta chấm điểm.
III. InstructGPT: khi sự hài lòng của con người trở thành tín hiệu huấn luyện
GPT-3 giỏi hoàn thành văn bản nhưng chưa giỏi làm theo chỉ dẫn. Đưa cho nó một yêu cầu, mô hình có thể tiếp tục viết yêu cầu ấy thay vì thực hiện nó. Ouyang và cộng sự (2022) đã thay đổi hành vi này bằng một quy trình huấn luyện ba giai đoạn.3
Giai đoạn SFT: supervised fine-tuning. Nhóm nghiên cứu sử dụng khoảng 13.000 prompt huấn luyện, đi kèm câu trả lời mẫu do con người viết, rồi fine-tune GPT-3 trong 16 epoch. Loss trên tập kiểm định bắt đầu tăng sau epoch đầu tiên, dấu hiệu cho thấy mô hình đã bắt đầu quá khớp theo thước đo dự đoán token. Tuy nhiên, điểm từ mô hình phần thưởng và đánh giá ưa thích của con người vẫn tăng, nên nhóm tiếp tục huấn luyện. Nói cách khác, họ chấp nhận giảm chất lượng theo một thước đo để đổi lấy hành vi gần hơn với hình mẫu "trợ lý hữu ích".
Giai đoạn reward model. Với mỗi prompt, hệ thống tạo ra nhiều câu trả lời để người gán nhãn xếp hạng. Từ dữ liệu so sánh ấy, nhóm huấn luyện một mô hình 6 tỷ tham số (khởi tạo từ mô hình SFT sau khi bỏ lớp unembedding cuối). Mô hình này xuất ra một điểm số vô hướng, dùng để dự đoán câu trả lời nào được con người ưa thích hơn.
Giai đoạn PPO. Mô hình SFT tiếp tục được tối ưu bằng PPO, lấy điểm từ reward model làm tín hiệu. Hàm mục tiêu có thêm khoản phạt KL để mô hình không trôi quá xa khỏi chính sách ban đầu chỉ nhằm "cày điểm". Ở biến thể PPO-ptx, nhóm còn trộn thêm gradient từ dữ liệu tiền huấn luyện để giảm alignment tax, tức phần năng lực trên một số benchmark NLP bị suy giảm sau quá trình căn chỉnh.
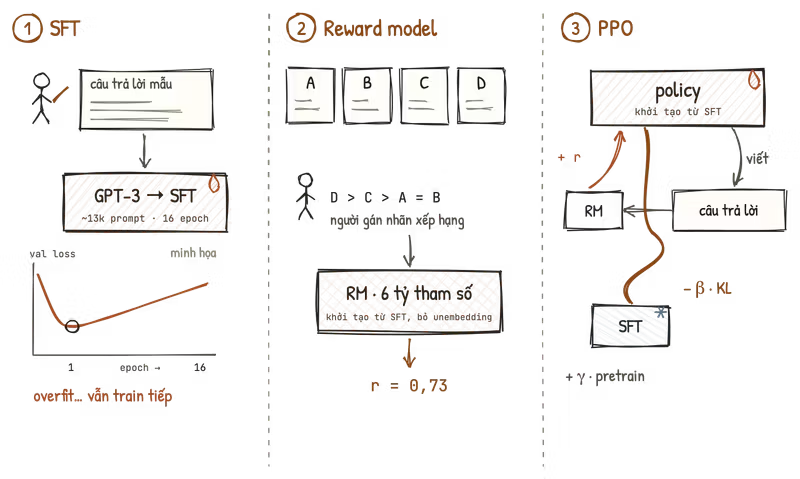
Mỗi cột trong hình là một giai đoạn. Ở cột đầu, đường loss chỉ là hình minh họa, không phải số liệu gốc, nhưng hình dáng của nó đúng như bài báo thừa nhận: chạm đáy sau epoch đầu tiên rồi đi lên, mà việc huấn luyện vẫn tiếp tục. Ở cột cuối, sợi dây nối policy với bản SFT đóng băng chính là khoản phạt KL.
Quy trình này không chỉ làm câu trả lời "dễ nghe" hơn. Theo đánh giá của nhóm nghiên cứu, InstructGPT còn cải thiện khả năng làm theo chỉ dẫn, tăng tính hữu ích, cải thiện độ trung thực trong một số phép đo và giảm nội dung độc hại. Nhưng phạm vi tối ưu vẫn bị ràng buộc bởi dữ liệu và tiêu chí của người đánh giá.
Nếu người chấm chỉ nhìn vào câu trả lời cuối cùng, mô hình được thưởng cho việc tạo ra câu trả lời khiến họ hài lòng. Nó chưa vì thế mà có quyền gọi API, đọc trạng thái thật từ terminal hay kiểm tra một hàng trong cơ sở dữ liệu. Những năng lực ấy đòi hỏi công cụ, quyền truy cập, runtime và cơ chế xác minh ở cấp hệ thống.
Việc prompt engineering trở nên hiệu quả hơn sau InstructGPT không phải chuyện thần bí. Mô hình đã được huấn luyện để phản hồi tốt hơn trước chỉ dẫn bằng ngôn ngữ. Nhưng làm theo lời người dùng vẫn không đồng nghĩa với được nối vào một nguồn sự thật.
IV. RAG: từ một kiến trúc học được đến một pipeline thường bị đóng băng
Đến đây, một câu hỏi tự nhiên xuất hiện: nếu prompt không thể tự mang lại dữ liệu hiện hành, tại sao không lấy dữ liệu từ bên ngoài rồi đặt ngay trước mặt mô hình? Đó là lúc ngành công nghiệp chuyển sang một hướng thực tế hơn. Từ năm 2023, RAG (Retrieval-Augmented Generation) trở thành câu trả lời quen thuộc trong nhiều cuộc thảo luận về AI doanh nghiệp.
Tuy nhiên, RAG mà Lewis và cộng sự công bố năm 2020 là một kiến trúc cụ thể hơn nhiều so với cách thuật ngữ này thường được dùng hiện nay.4
Nhóm nghiên cứu tách bộ nhớ thành hai phần. Bộ nhớ tham số nằm trong mô hình sinh BART-large. Bộ nhớ phi tham số nằm trong một chỉ mục gồm khoảng 21 triệu đoạn Wikipedia, được truy xuất bằng DPR. Khi tinh chỉnh trên nhiệm vụ đích, hệ thống coi tài liệu truy xuất là biến ẩn, xấp xỉ bằng top-, rồi tối ưu xác suất của câu trả lời đúng sau khi đã lấy tổng theo các tài liệu ứng viên.
Điểm quan trọng nằm ở chỗ mô hình sinh và bộ mã hóa câu hỏi của retriever được học cùng nhau. Gradient giúp retriever điều chỉnh cách biểu diễn câu hỏi để ưu tiên những tài liệu có ích cho việc sinh đáp án. Bộ mã hóa tài liệu và chỉ mục được giữ cố định trong thiết lập của bài báo; các thành phần còn lại không đơn thuần vận hành theo kiểu copy-paste.
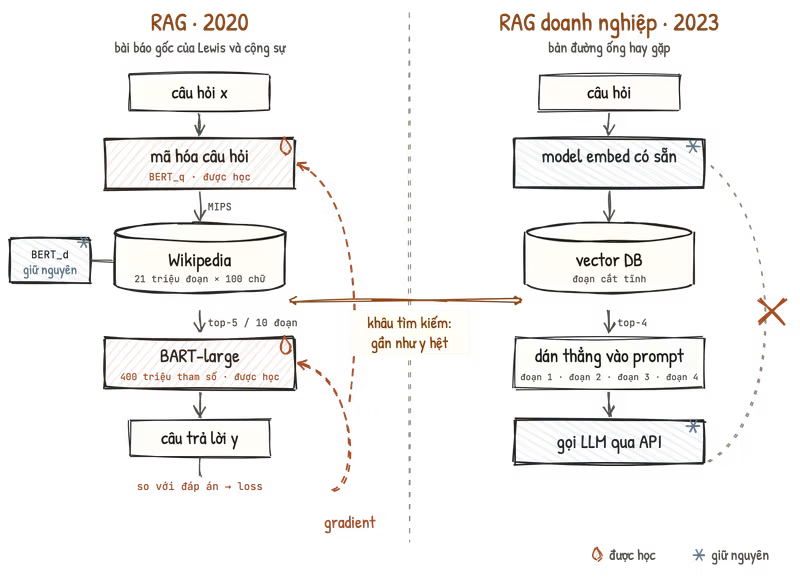
Hai cột đọc từ trên xuống. Khúc giữa của hai bên gần như giống hệt nhau: một kho đoạn văn đã cắt sẵn (bản gốc cũng cắt Wikipedia thành những đoạn 100 chữ), tra bằng vector, lấy về vài đoạn đầu. Chỗ khác nằm ở những đường nét đứt. Bên trái, gradient chảy ngược lên BART rồi lên tận bộ mã hóa câu hỏi; hai khối có ngọn lửa là hai khối được học, còn bộ mã hóa tài liệu thì đóng băng. Bên phải, khối nào cũng đóng băng, và đường quay ngược về bị gạch chéo.
Trong thực tế doanh nghiệp, RAG thường xuất hiện dưới dạng một pipeline đơn giản hơn:
- chunking: chia tài liệu thành các đoạn;
- embedding: mã hóa các đoạn bằng một mô hình có sẵn;
- top- retrieval: lấy một số kết quả gần nhất;
- prompt augmentation: đưa các kết quả ấy vào prompt;
- generation: yêu cầu mô hình tạo câu trả lời.
Pipeline này có thể rất hữu ích. Tuy vậy, phần lớn thành phần bên trong thường không tự học từ việc câu trả lời cuối cùng đúng hay sai. Vì thế, chất lượng hệ thống phụ thuộc vào chunking strategy, embedding model, query formulation, metadata filtering, reranking, prompt construction và cả năng lực đọc hiểu của generator.
Để khắc phục các điểm yếu ấy, những hệ thống mới bổ sung reranking, context compression, query rewriting, multi-hop retrieval và evaluation loops. Nhờ vậy, chất lượng có thể được cải thiện rõ rệt. Tuy nhiên, nếu dữ liệu nguồn đã cũ, đoạn quan trọng bị cắt đôi hoặc nhiệm vụ thật sự là ghi dữ liệu vào hệ thống, retrieval tốt hơn vẫn chưa đủ. Một read-only pipeline không tự nhiên biến thành một pipeline có khả năng hành động.
Do đó, cần phân biệt hai mệnh đề:
- RAG giúp mô hình tiếp cận thông tin bên ngoài trọng số.
- RAG, nếu chỉ dừng ở truy xuất và sinh văn bản, chưa tạo ra đầy đủ năng lực của một hệ thống phần mềm có trạng thái và có hành động.
Nói cách khác, RAG nguyên bản là một mô hình xác suất trong đó retriever và generator được fine-tune cùng nhau. Trong khi đó, nhiều hệ thống ngày nay dùng "RAG" theo nghĩa rộng hơn: tìm tài liệu rồi đưa vào ngữ cảnh. Cùng một tên gọi, nhưng cơ chế học và mức độ tích hợp rất khác nhau.
V. Tài liệu đúng vẫn có thể bị bỏ quên giữa ngữ cảnh
Có một điểm cực kỳ thú vị: hệ thống có thể truy xuất đúng tài liệu mà mô hình vẫn không sử dụng đúng thông tin bên trong. Nói cách khác, retrieval quality mới chỉ là một nửa của bài toán; nửa còn lại nằm ở cách thông tin được sắp xếp trong context.
Điều này được thể hiện rất rõ trong Lost in the Middle (Liu và cộng sự, TACL 2024).5 Nhóm nghiên cứu thay đổi vị trí của tài liệu chứa đáp án trong một bài toán hỏi–đáp nhiều tài liệu. Khi số tài liệu tăng và đoạn liên quan bị đẩy vào giữa, hiệu suất của nhiều mô hình giảm theo một đường cong hình chữ U: tốt hơn ở đầu, tốt hơn ở cuối, yếu hơn ở giữa.
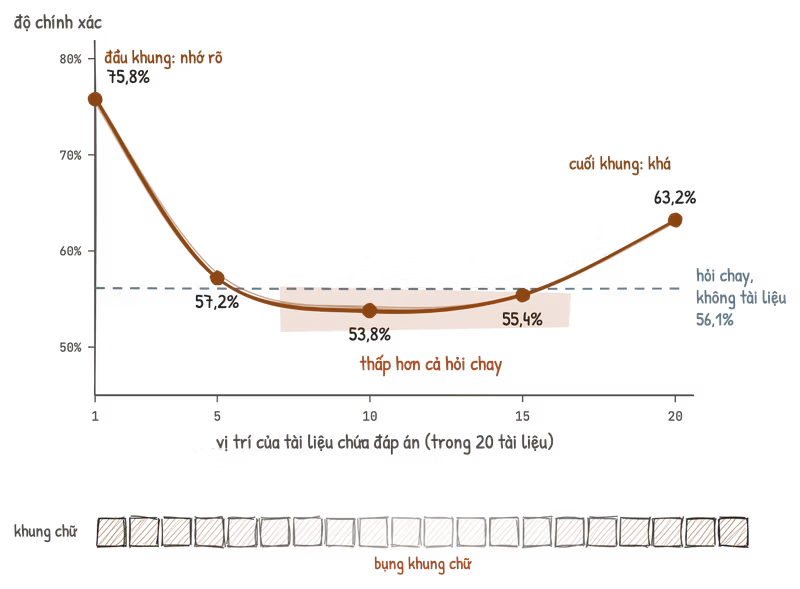
Hình này được vẽ lại từ chính bảng số liệu trong bài báo, với GPT-3.5-Turbo và 20 tài liệu. Đường nét đứt màu xanh xám là mức 56,1% khi hỏi chay, không đưa tài liệu nào. Vùng tô đỏ là chỗ đường cong chui xuống dưới mức ấy. Dải ô vuông dưới cùng là khung ngữ cảnh: càng vào giữa, tài liệu càng mờ đi trong mắt mô hình.
Đáng chú ý hơn, với GPT-3.5-Turbo, khi tài liệu liên quan nằm giữa context, kết quả có lúc còn thấp hơn mức 56,1% của chế độ closed-book (trả lời mà không được cung cấp tài liệu). Trong trường hợp ấy, thêm tài liệu không giúp mô hình biết nhiều hơn; trái lại, nó khiến tín hiệu cần thiết khó được sử dụng hơn.
Xu hướng này cũng không biến mất khi context window dài hơn. GPT-3.5-Turbo 16K cho phép đưa thêm token vào, nhưng vẫn không bảo đảm mô hình sẽ khai thác mọi vị trí đồng đều.
Không dừng lại ở đó, báo cáo kỹ thuật Context Rot của Chroma năm 2025 mở rộng quan sát này trên 18 mô hình, trong đó có GPT-4.1, Claude 4, Gemini 2.5 và Qwen3.6 Kết quả cho thấy hiệu suất nhìn chung trở nên kém ổn định khi đầu vào dài hơn, ngay cả trong những thí nghiệm được thiết kế để tách ảnh hưởng của độ dài khỏi độ khó của nhiệm vụ. Dù đây là báo cáo kỹ thuật chứ không phải bằng chứng cuối cùng cho mọi loại tác vụ, kết quả vẫn củng cố một cảnh báo quan trọng: context window lớn không đồng nghĩa với khả năng sử dụng context một cách đồng đều.
Từ hai quan sát trên, có thể rút ra hai hệ quả thực tế.
Trước hết, retrieval ranking không đồng nghĩa với mức độ mô hình sẽ chú ý và sử dụng từng đoạn. Đoạn đúng có thể được truy xuất nhưng lại rơi vào vị trí bất lợi trong prompt.
Kế đến, nhiều context hơn không mặc nhiên tạo ra nhiều hiểu biết hơn. Qua một ngưỡng nào đó, ta không còn làm nổi bật thông tin mà đang chôn nó giữa nhiễu.
Bởi vậy, context engineering không chỉ là bài toán "lấy được gì", mà còn là bài toán "giữ lại gì, bỏ đi gì và đặt ở đâu". Hãy xem context window như mặt bàn làm việc: diện tích có hạn, mọi thứ đặt lên đó đều phải có lý do.
VI. Giới hạn của một kiến trúc chỉ xoay quanh ngôn ngữ
Prompt engineering và RAG thường bị kỳ vọng quá mức vì cùng một ngộ nhận: nếu mô hình được cung cấp đủ lời lẽ và đủ tài liệu, nó sẽ tự trở thành một hệ thống hoàn chỉnh.
Nhưng doanh nghiệp không chỉ cần một cỗ máy biết đọc và viết. Họ cần hệ thống có thể kiểm tra quyền hạn, đọc trạng thái hiện thời, ghi một hàng dữ liệu, gửi thông báo, khởi động lại dịch vụ, chờ kết quả, xử lý lỗi và từ chối hành động khi thiếu bằng chứng.
Đó là các thao tác lên thế giới bên ngoài, không phải chỉ là văn bản.
Prompt thay đổi điều kiện đầu vào của phép dự đoán. RAG bổ sung dữ liệu vào điều kiện ấy. Ở tầng mô hình, cả hai vẫn tác động lên cùng một biểu thức:
Tự thân chúng không cấp quyền truy cập, không tạo giao dịch cơ sở dữ liệu, không xác lập cơ chế hoàn tác và không bảo đảm rằng kết quả vừa sinh ra khớp với trạng thái thật. Chúng cũng không sửa lại mục tiêu tiền huấn luyện đã hình thành xu hướng ưu tiên một chuỗi trôi chảy.
Một kiến trúc đáng tin cậy bắt đầu xuất hiện khi đầu ra của mô hình không còn là điểm kết thúc. Chuỗi token phải được chuyển thành một yêu cầu có cấu trúc; yêu cầu ấy phải đi qua lớp kiểm tra quyền hạn và ràng buộc; runtime phải trả về trạng thái rõ ràng; rồi mô hình mới được phép diễn giải kết quả cho người dùng.
Khi đó, hệ thống không chỉ "nói rằng đã làm". Nó có bằng chứng cho biết hành động đã thành công, thất bại hay bị từ chối.
Prompt engineering và RAG không vô dụng. Ngược lại, chúng là hai thành phần quan trọng của nhiều hệ thống tốt. Sai lầm nằm ở việc coi chúng là toàn bộ kiến trúc.
Chúng giúp cải thiện điều mô hình nói ra. Còn một hệ thống phần mềm đáng tin cậy phải chịu trách nhiệm cả cho những gì nó đọc, những gì nó được phép làm, những gì nó thực sự đã làm và cách nó chứng minh điều đó.
- Tom B. Brown và cộng sự, Language Models are Few-Shot Learners, NeurIPS 2020. Số liệu LAMBADA ở Bảng 3.2; zero/one/few-shot ở Hình 2.1. ↩
- Adam Tauman Kalai, Ofir Nachum, Santosh S. Vempala, Edwin Zhang, Why Language Models Hallucinate, 2025. ↩
- Long Ouyang và cộng sự, Training language models to follow instructions with human feedback, NeurIPS 2022. SFT và reward model ở mục 3.5, hàm mục tiêu và PPO-ptx ở phương trình (2). ↩
- Patrick Lewis và cộng sự, Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, NeurIPS 2020. Việc giữ cố định bộ mã hóa tài liệu ở mục 2.4. ↩
- Nelson F. Liu và cộng sự, Lost in the Middle: How Language Models Use Long Contexts, TACL 12 (2024), tr. 157–173. Số liệu ở Bảng 1 và Bảng 6. ↩
- Kelly Hong, Anton Troynikov, Jeff Huber, Context Rot: How Increasing Input Tokens Impacts LLM Performance, Chroma, tháng 7/2025. ↩
— espresso.hoagg